
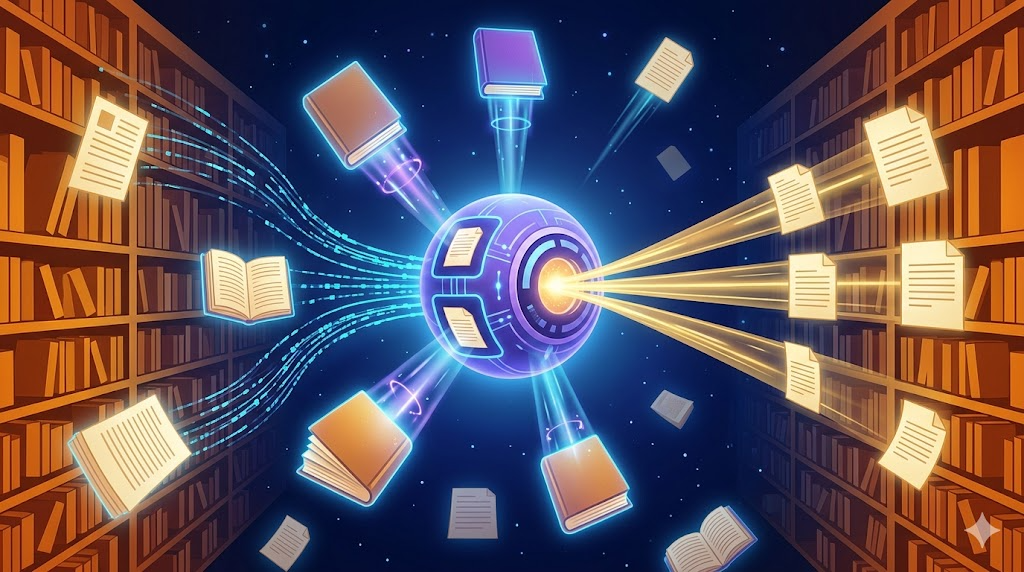

RAG(Retrieval-Augmented Generation:検索拡張生成)とは、大規模言語モデル(LLM)が質問に関連する情報を外部データベースから検索し、その情報をもとに回答を生成する仕組みです。ファインチューニング(モデルの再学習)を行わずに、社内文書やマニュアルなど自社データに基づいた回答をAIにさせられる点が特徴です。
「ChatGPTは便利だけど、社内データについて答えられない」——この課題を解決するのがRAGです。RAGを使えば、自社の社内文書、マニュアル、FAQ、ナレッジベースをAIが参照して回答できるようになります。この記事では、公開情報をもとにRAGの仕組みと技術スタック、企業での活用事例、導入時の注意点までを解説します。
RAGの仕組み:検索→プロンプトへの追加→生成
RAGの処理は、大きく3つのステップで進みます。
- 検索(Retrieval):ユーザーの質問をベクトル化し、ベクトルデータベースの中から意味が近い文書を検索します。
- プロンプトへの追加:検索して見つかった文書の内容を、LLMに渡すプロンプトの中にコンテキストとして組み込みます。
- 生成(Generation):LLMが、追加されたコンテキストを踏まえて回答を生成します。
この仕組みにより、モデル自体を再学習させなくても、最新の社内情報や専門知識に基づいた回答が可能になります。データを更新したいときも、ベクトルデータベースの中身を更新するだけで済むため、運用の手間が比較的小さいのがメリットです。
ファインチューニングとの違い
RAGとよく比較されるのが、モデル自体を追加学習させるファインチューニングです。ファインチューニングは学習データの整備とGPUコストがかかり、モデルの知識を更新するにはあらためて学習し直す必要があります。
一方RAGは、既存のドキュメントをほぼそのまま検索対象にできるため、比較的低コストで構築でき、データの更新もベクトルデータベースの更新だけで済みます。そのため、社内文書のように更新頻度が高い情報を扱う用途では、RAGの方が扱いやすいとされています。
RAGが注目される理由
ハルシネーション(幻覚)の軽減
LLMは学習データをもとに、もっともらしい誤った情報を生成してしまうことがあります。RAGでは実際のドキュメントを参照しながら回答するため、事実に基づいた回答をしやすくなります。
最新情報への対応
LLMの学習データには時点の制約がありますが、RAGなら参照先のデータを更新するだけで、比較的新しい情報に基づいた回答がしやすくなります。
導入コストの低さ
ファインチューニングに比べて、既存のドキュメントをそのまま活用できるため、比較的低コストで構築を始めやすいとされています。
RAGの技術スタック
ベクトルデータベース
RAGの核となるのがベクトルデータベースです。文書をベクトル(数値の配列)に変換して格納し、類似度検索を実行します。選択肢としては、Pinecone(マネージド型で運用しやすい)、Weaviate(オープンソースで柔軟性が高い)、Qdrant(Rust製で高速)、Chroma(軽量でプロトタイプ向け)などがあります。
Embeddingモデル
文書をベクトルに変換するEmbeddingモデルの選択も重要です。OpenAIのtext-embedding-3-small/largeが定番の一つで、コストを重視する場合はCohereのembed-v3、オンプレミス運用ならBGE-M3(オープンソース)などが選択肢になります。日本語の精度を重視する場合は、候補となるモデルを実際に比較検証することをおすすめします。
オーケストレーションフレームワーク
RAGパイプラインの構築には、LangChainまたはLlamaIndexが使われることが多いです。LangChainは汎用性が高く多様なユースケースに対応しやすく、LlamaIndexはRAGに特化した設計で文書インデックスの管理がしやすいという特徴があります。
企業でのRAG活用事例
社内ヘルプデスクの自動化
社内規程、就業規則、IT手順書をRAGで参照できるようにし、従業員からの質問にAIが自動で回答するシステムです。問い合わせ対応の負荷を減らせた事例が報告されています。
カスタマーサポートの品質向上
製品マニュアル、FAQ、過去の対応履歴をRAGで活用し、サポート担当者にリアルタイムで回答案を提示するシステムです。対応時間の短縮と、回答内容のばらつきを抑える効果が期待されています。
法務・コンプライアンスの効率化
契約書テンプレート、法令データベース、社内ポリシーをRAGで参照し、法務関連の質問に回答するシステムです。弁護士による確認が必要な案件のスクリーニングに活用されている例があります。
導入時の注意点
チャンキング戦略が精度を左右する
文書をどの粒度で分割(チャンキング)するかがRAGの精度に直結します。段落単位、セクション単位、固定長など、データの特性に合わせた戦略が必要です。
検索精度の評価を忘れない
RAGの性能はLLMの能力だけでなく、検索(Retrieval)の精度に大きく依存します。適合率(Precision)と再現率(Recall)を定期的に測定しましょう。
データの前処理を丁寧に行う
PDFの表やグラフ、HTMLの装飾タグなど、非構造データの前処理品質がRAGの精度を大きく左右します。
ハイブリッド検索を検討する
ベクトル検索だけでなく、キーワード検索(BM25)とのハイブリッドにすることで、検索精度が向上するケースが多いです。
権限管理を検索結果に反映する
RAGで参照させる文書の中には、閲覧権限が限定されているものも含まれます。検索結果やLLMの回答が、閲覧権限のないユーザーに機密情報を見せてしまわないよう、検索の段階でアクセス権限に応じたフィルタリングを行う設計が必要です。
回答の出典を必ず表示する
RAGの回答がどのドキュメントに基づいているかを明示することで、ユーザーの信頼性が向上し、誤回答の発見も容易になります。
まとめ:RAGはAI活用の実用的なアプローチ
RAGは「自社データ×LLM」で独自のAIアシスタントを構築するための、実用的なアプローチの一つです。ファインチューニングと比べて低コスト・低リスクで始めやすく、データの更新も容易です。
まずはLlamaIndexなどのチュートリアルを参考に小さなRAGシステムを構築し、社内の少量のドキュメントで動作を検証してみてください。手応えを感じたら、段階的にデータを拡大していくとよいでしょう。
あわせて読みたい:AI契約書レビューツール比較5選/AI動画編集ツール5選
よくある質問
Q. RAGとファインチューニングは何が違いますか?
ファインチューニングはモデル自体を追加学習させる手法で、データ整備とGPUコストがかかります。RAGは既存のドキュメントを検索対象にしてプロンプトに追加する仕組みで、モデルを再学習させずに済み、データの更新もベクトルデータベースの更新だけで完了します。
Q. RAG導入で最初に気をつけることは?
文書をどの粒度で分割するか(チャンキング)が精度に直結するため、データの特性に合わせた分割戦略を検討することが最初のポイントです。あわせて、検索の適合率・再現率を定期的に評価する体制も整えましょう。
Q. RAGはハルシネーション(幻覚)をなくせますか?
完全になくすものではありませんが、実際のドキュメントを参照しながら回答する仕組みのため、事実に基づいた回答をしやすくなります。回答の出典を明示することで、誤りにも気づきやすくなります。
コメント